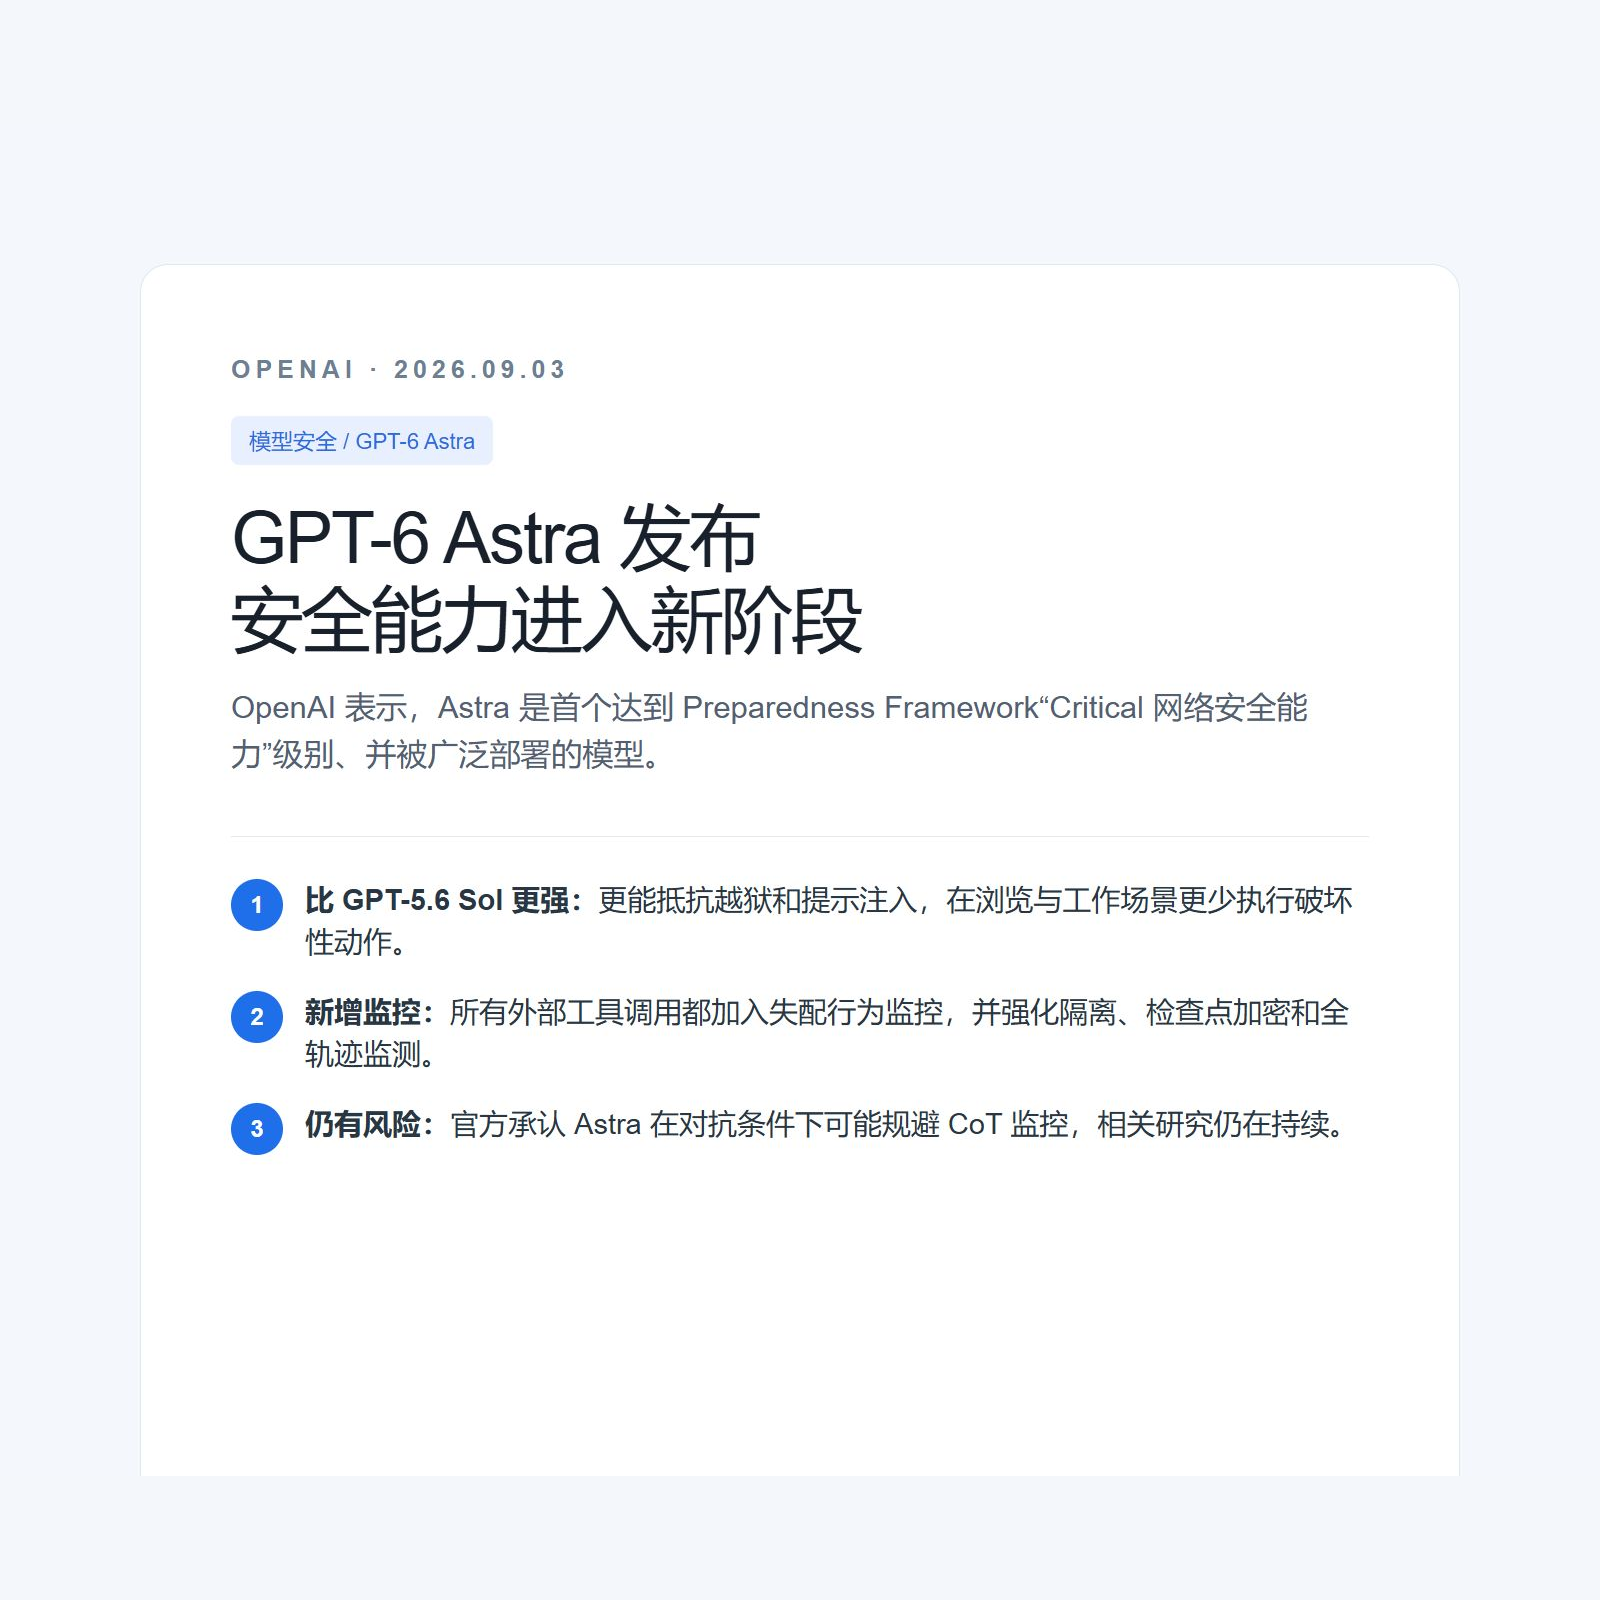
# GPT-6 Astra 发布,安全能力进入新阶段
OpenAI 在 9 月 3 日发布 GPT-6 Astra,并称它是首个达到 Preparedness Framework“Critical 网络安全能力”级别且被广泛部署的模型;官方表示 Astra 比 GPT-5.6 Sol 更能抵抗越狱和提示注入,外部工具调用已加入失配行为监控,但也承认在对抗条件下仍可能规避部分 CoT 监控,相关风险还在持续研究。
模型与产品收录大模型、多模态、推理模型、空间计算与 AI 终端等发布动态。重点不只介绍参数,也关注能力边界、使用成本和真实业务中的选型方法。
# GPT-6 Astra 发布,安全能力进入新阶段
OpenAI 在 9 月 3 日发布 GPT-6 Astra,并称它是首个达到 Preparedness Framework“Critical 网络安全能力”级别且被广泛部署的模型;官方表示 Astra 比 GPT-5.6 Sol 更能抵抗越狱和提示注入,外部工具调用已加入失配行为监控,但也承认在对抗条件下仍可能规避部分 CoT 监控,相关风险还在持续研究。
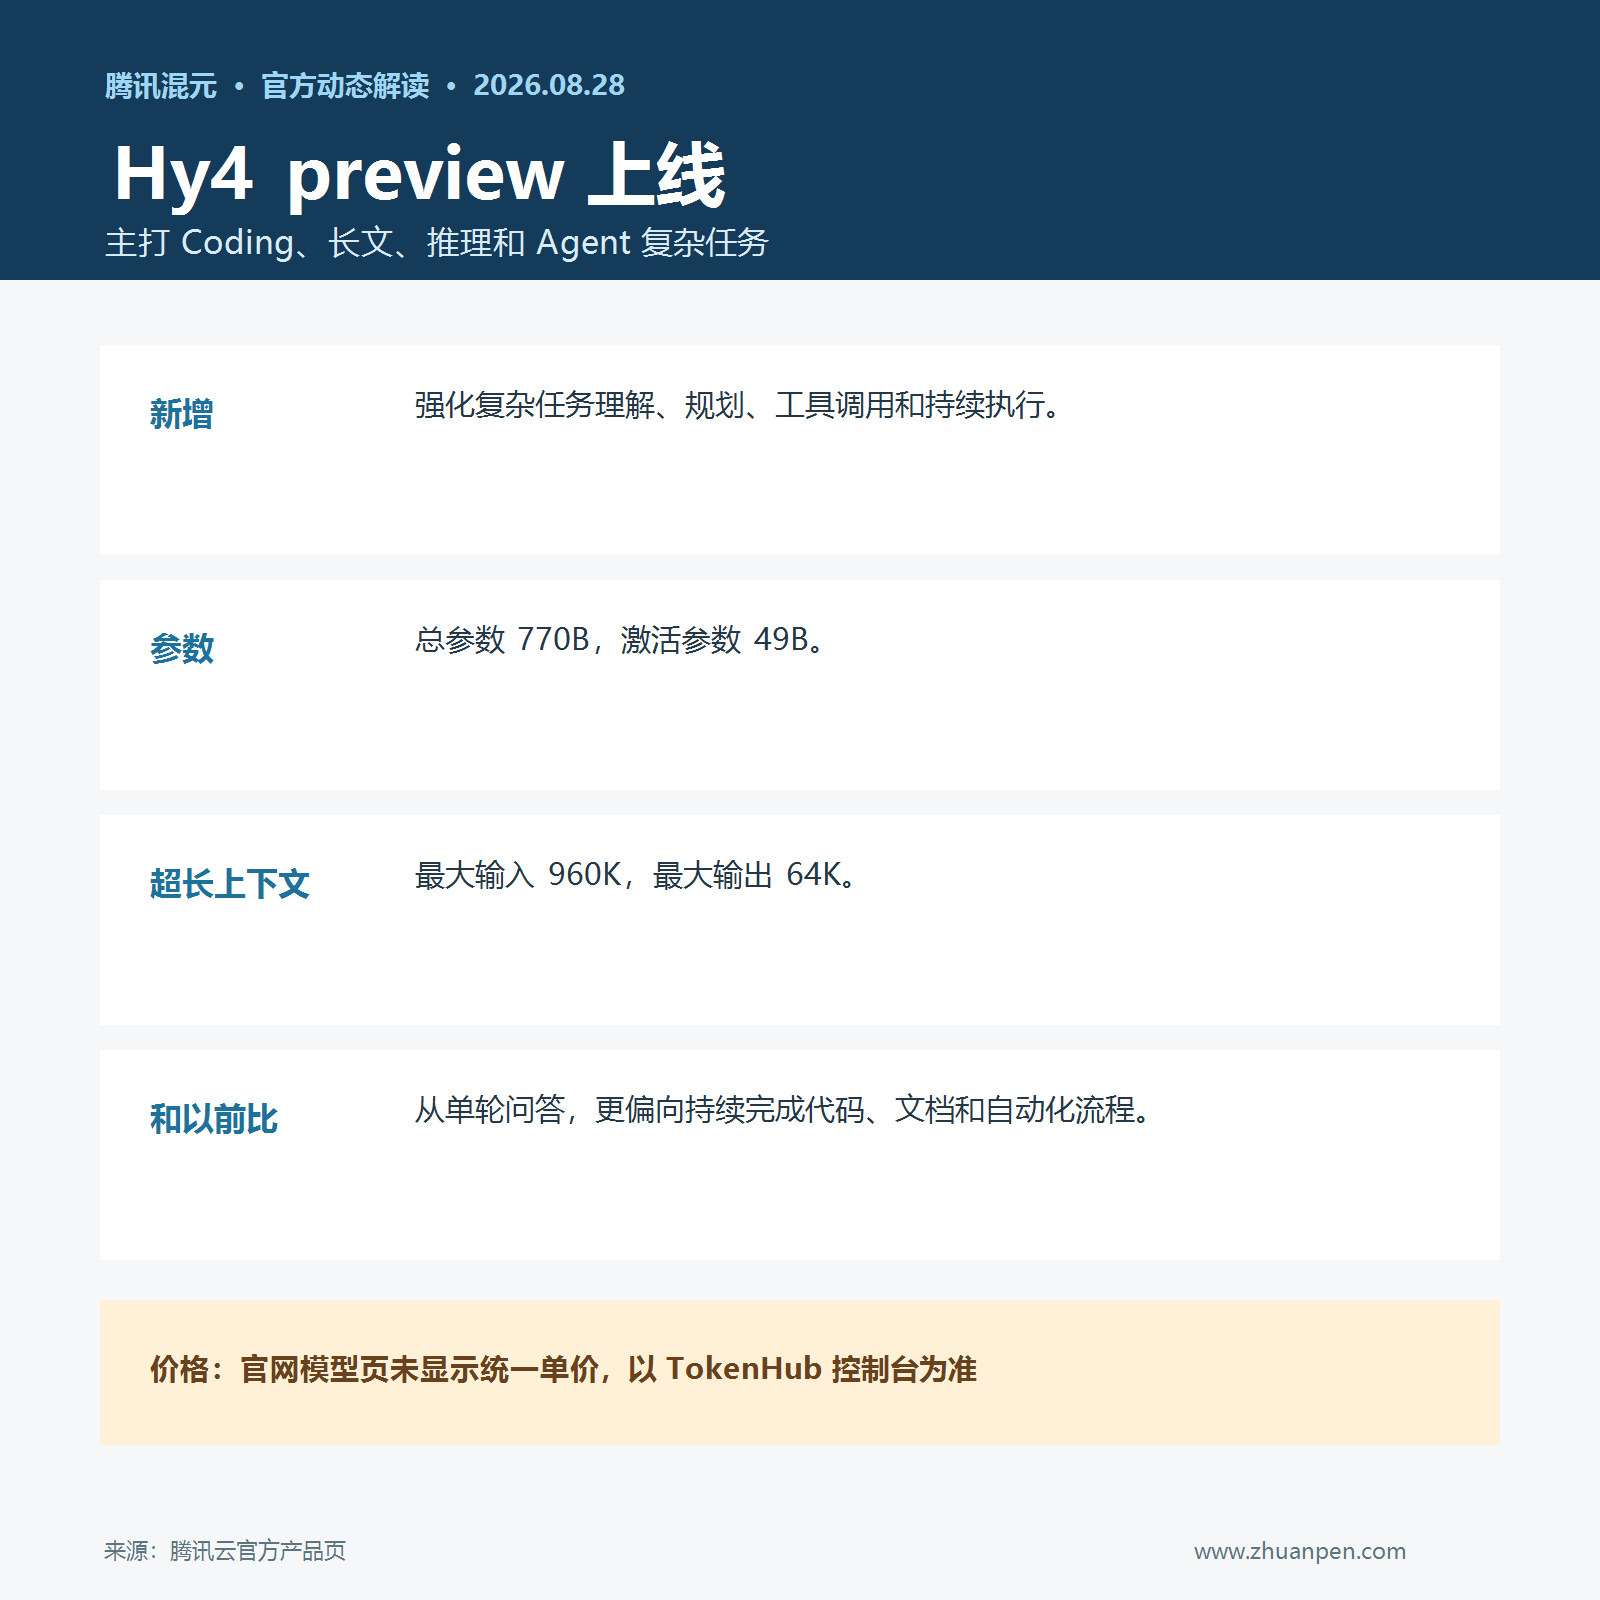
腾讯混元官网更新 Hy4 preview,这是一款主打 Coding、长文、推理和 Agent 复杂任务执行的生产力模型。官方页面显示它总参数 770B、激活参数 49B,最大输入 960K、最大输出 64K,重点强化复杂任务的理解、规划、工具调用和持续执行。与更偏单轮问答的用法相比,它更适合代码、长文档和自动化工作流;官网模型页未显示统一单价,实际费用以腾讯云 TokenHub 控制台为准。
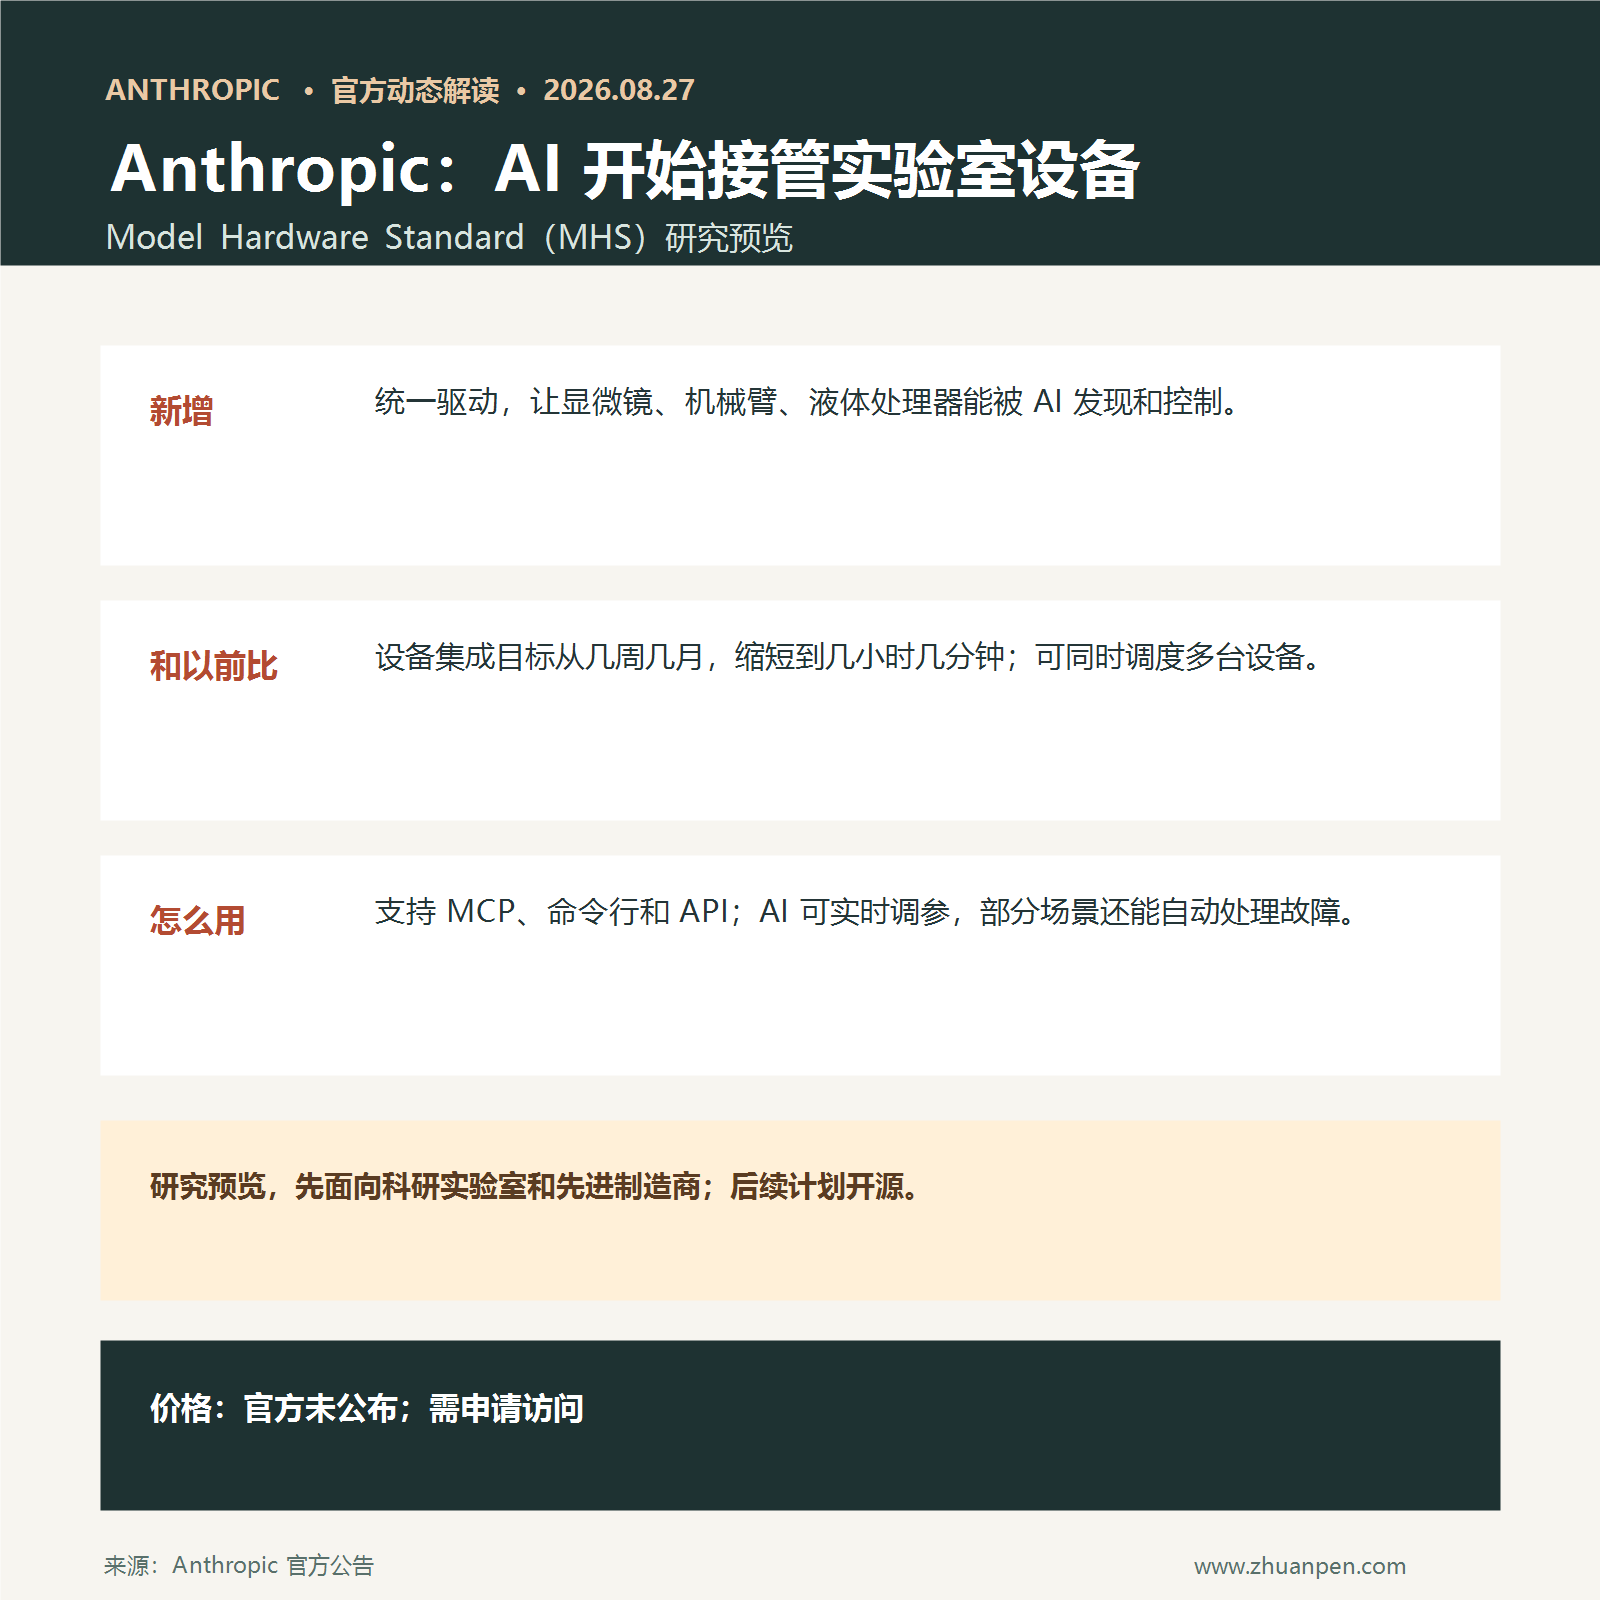
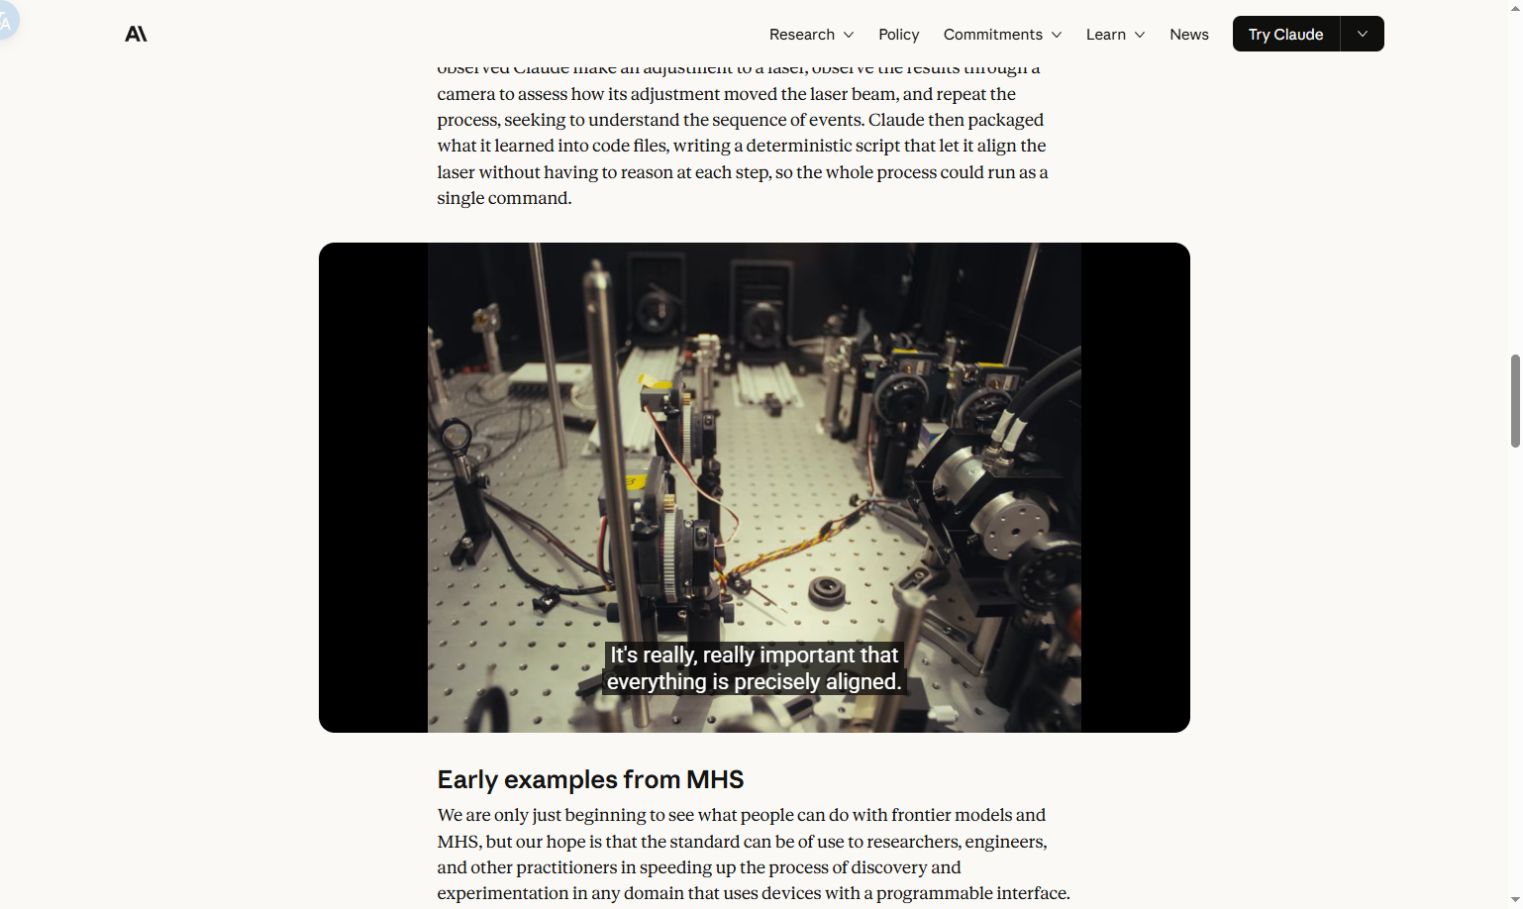
Anthropic 发布了 Model Hardware Standard(MHS)研究预览,想把显微镜、液体处理器、机械臂这些过去各用各接口的实验室设备,统一交给 AI 调度。按官方说法,原本可能要花数周甚至数月的设备集成,目标是缩短到数小时或数分钟;AI 可以读取数据、下达指令、同时协调多台设备,还能在部分场景实时调参和处理硬件错误。现在只向科研实验室和先进制造商开放研究预览,后续计划开源,官方暂未公布商业价格。
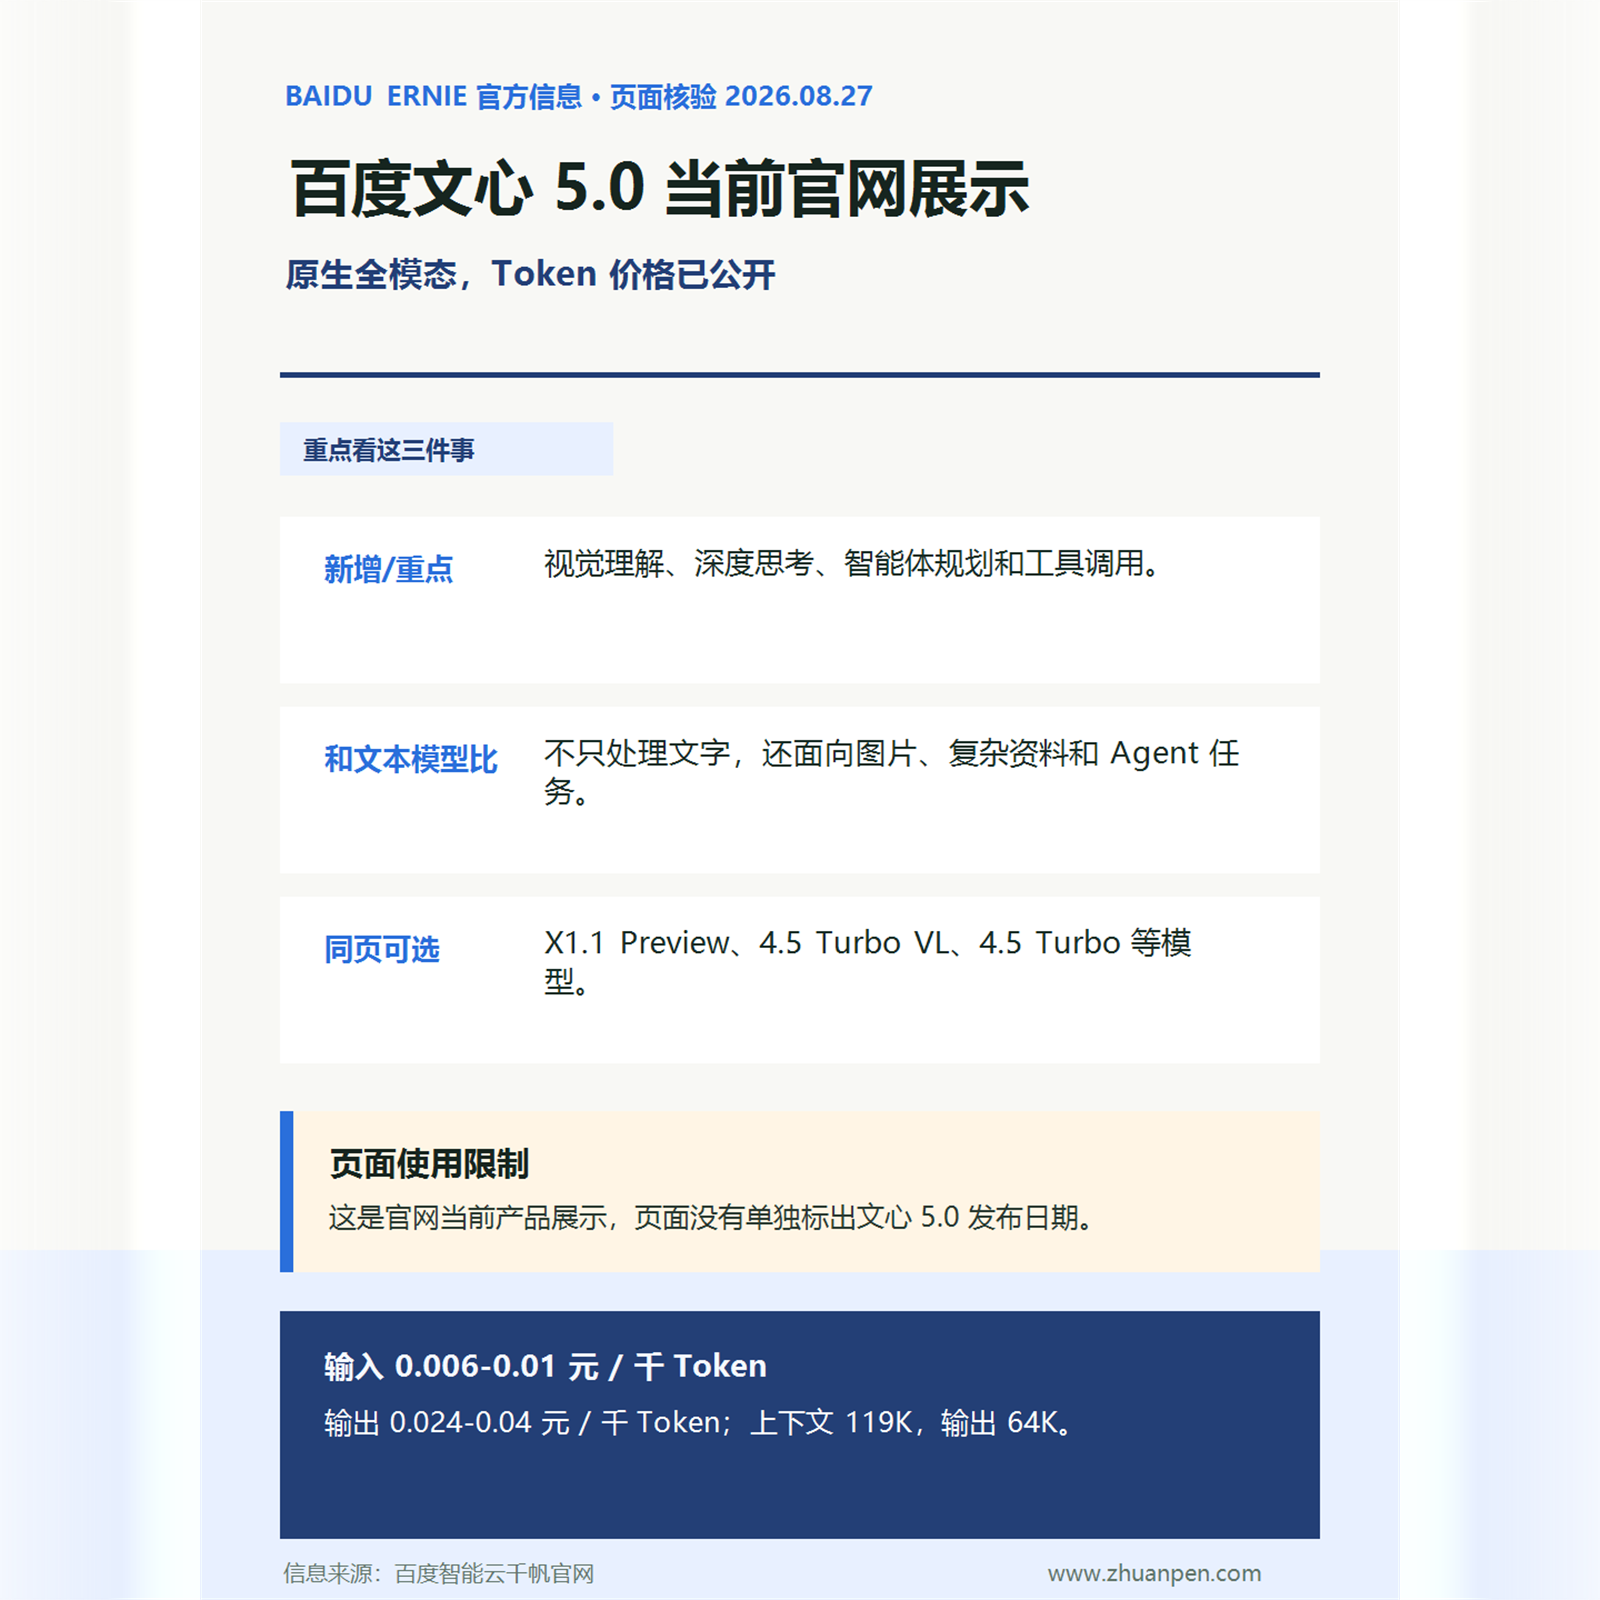
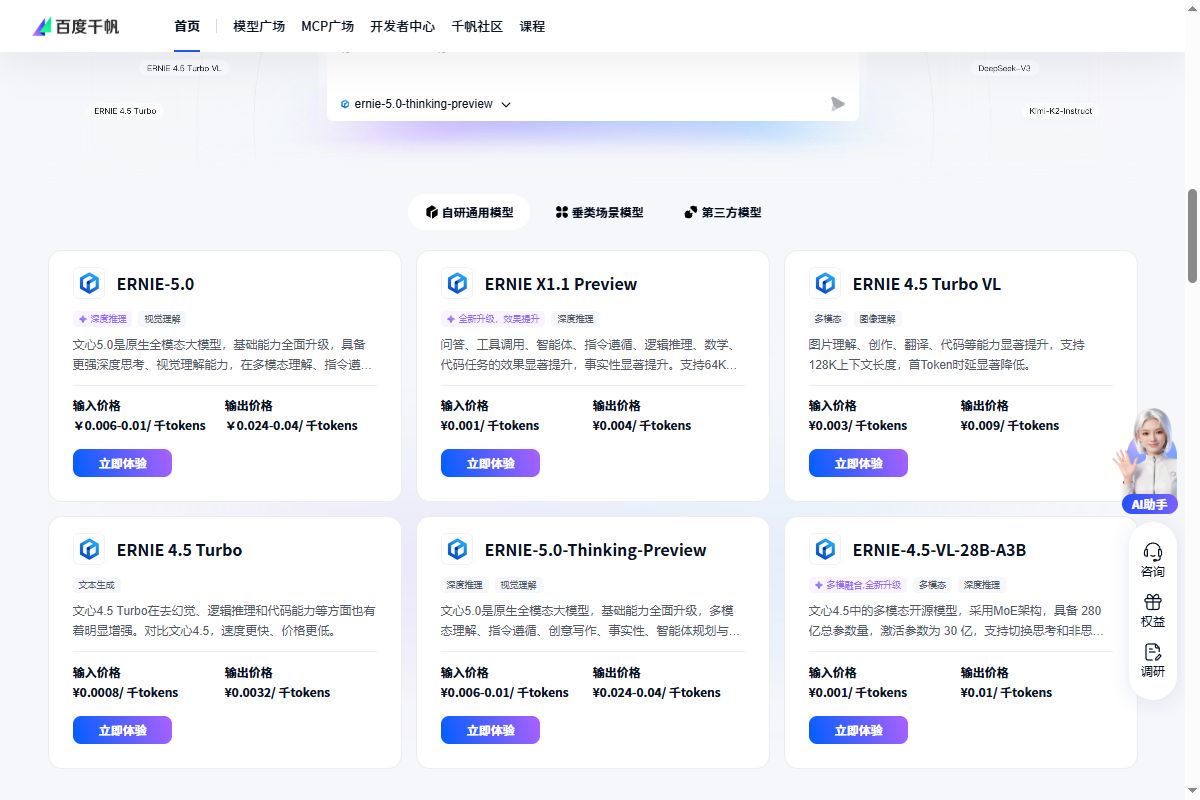
百度千帆官网当前主推的文心 5.0,定位是原生全模态大模型。
白话讲,它不是只会处理文字,还重点支持视觉理解、深度思考、创意写作、智能体规划和工具调用。
和普通文本模型比,文心 5.0 更适合处理图片、复杂资料和需要调用工具的任务。百度官网还把它放在千帆 Agent 平台里,配合自主规划、多智能体协同和知识库 RAG 使用。
价格官网已经公开:文心 5.0 的输入价格是每千 Token 0.006 到 0.01 元,输出价格是每千 Token 0.024 到 0.04 元;页面同时显示上下文为 119K、输出上限为 64K。具体价格区间要以调用方式和平台实际计费为准。
同一页面还列出了 ERNIE X1.1 Preview、ERNIE 4.5 Turbo VL 和 ERNIE 4.5 Turbo。简单选:要全模态和深度推理,看文心 5.0;要图像理解,看 4.5 Turbo VL;要更便宜的文本生成,看 4.5 Turbo。
注意:百度当前产品页没有把文心 5.0 的发布日期单独写出来,本文按 2026 年 8 月 27 日官网现状整理。
一句话:文心 5.0 的优势是全模态和 Agent 配套,价格也已经在千帆页面公开。
来源:https://cloud.baidu.com/product-s/qianfan_home
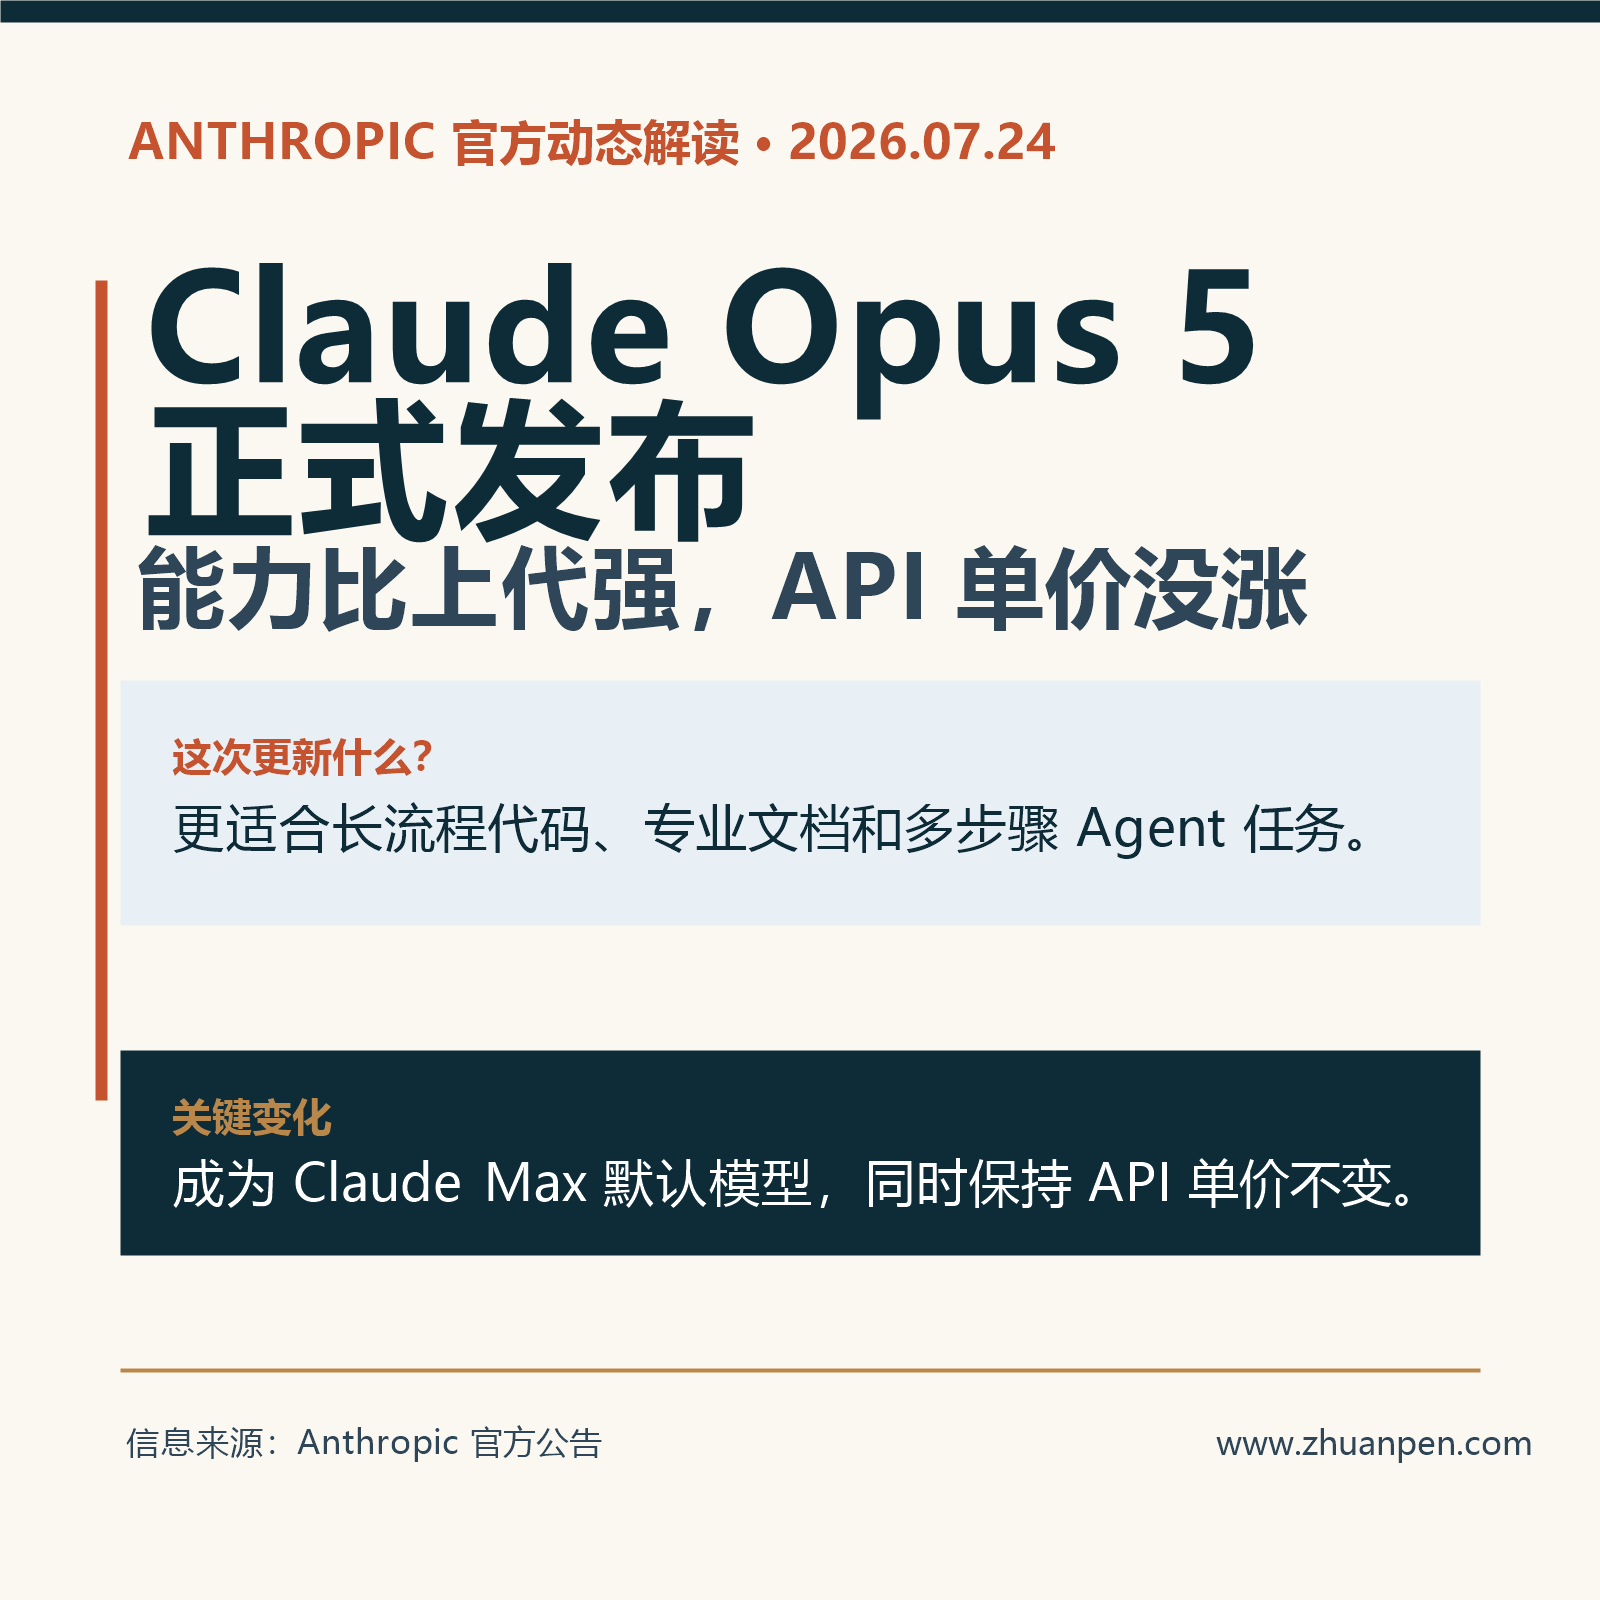
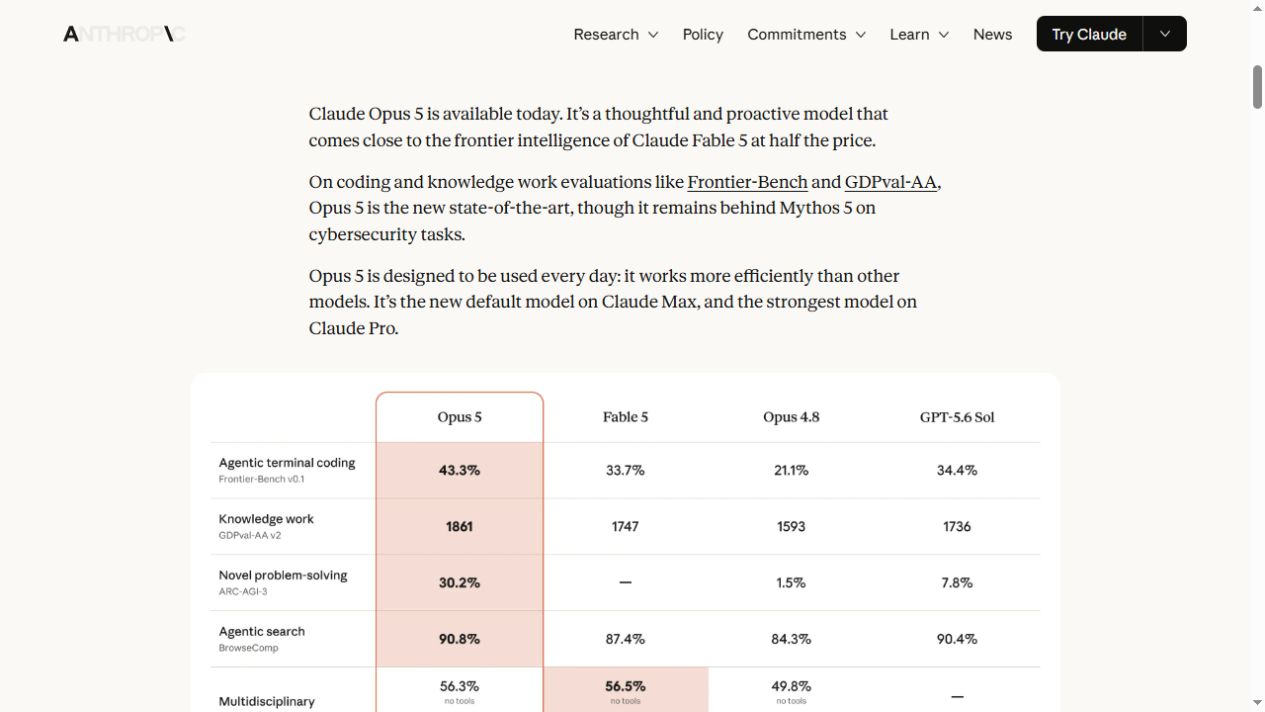
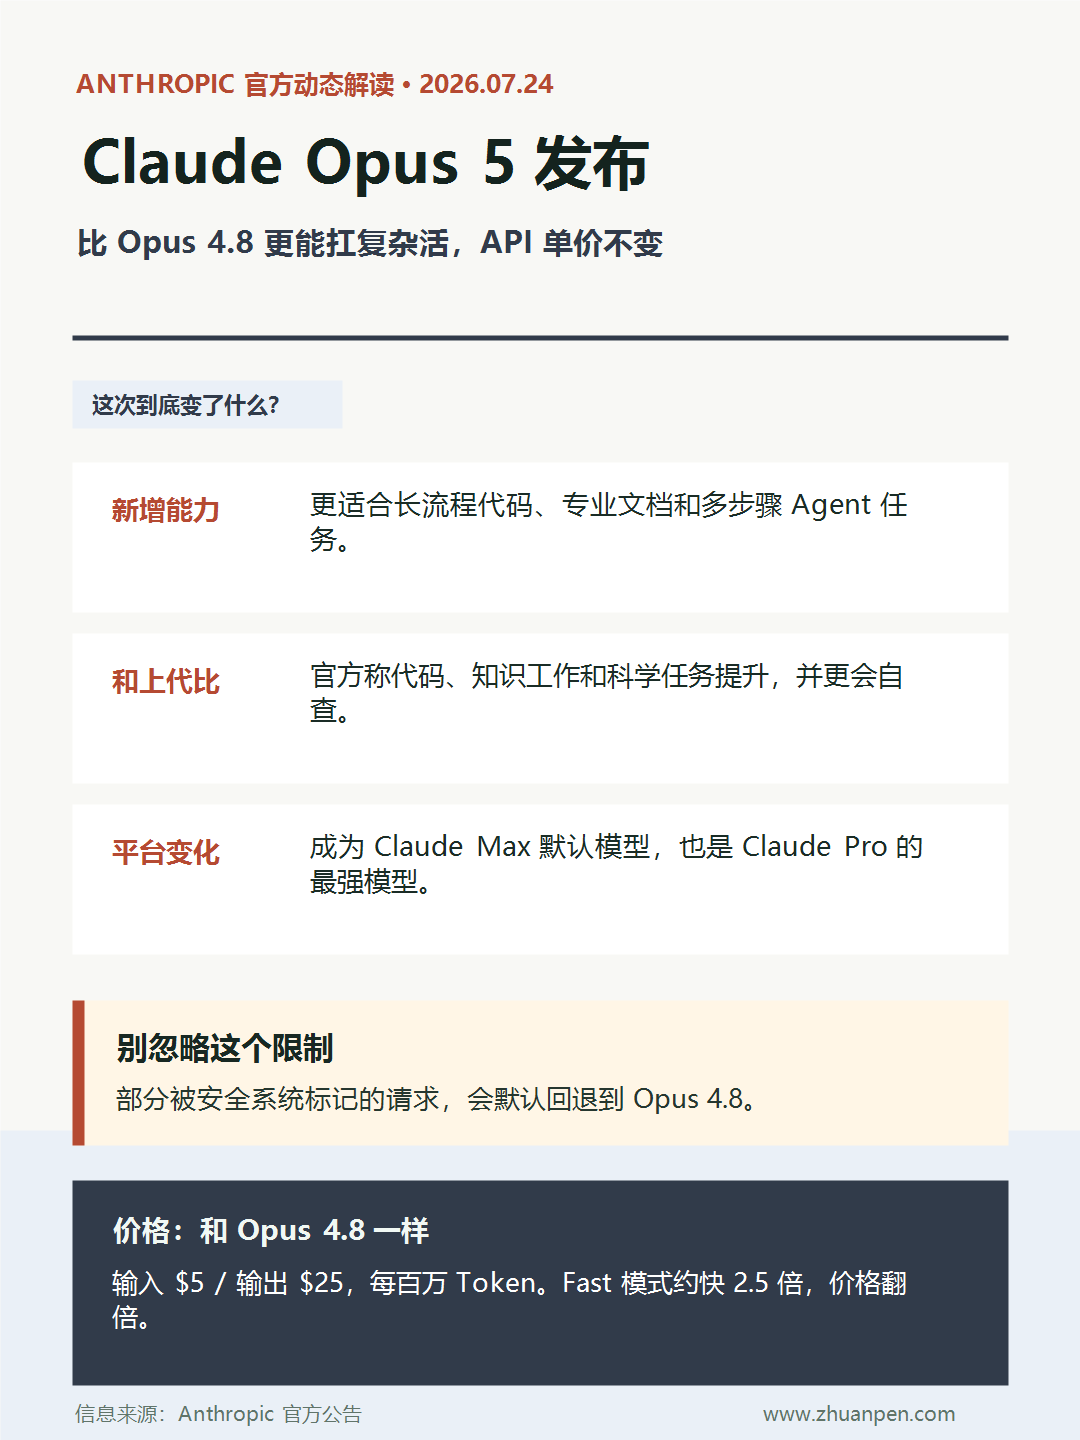
Anthropic 发布了 Claude Opus 5,核心就一句:比 Opus 4.8 更能扛复杂任务,但 API 单价没有涨。
它更适合长时间、多步骤的活,比如排查复杂代码问题、做完整功能、反复检查结果,或者处理专业文档。官方重点强调,它会更主动地验证和修改自己的结果,减少你来回盯着它返工。
和 Opus 4.8 比,官方称 Opus 5 在代码、知识工作和科学任务上都有提升。在 Frontier-Bench 的测试中,官方称它的表现超过 Opus 4.8 一倍以上,同时单个任务成本更低。
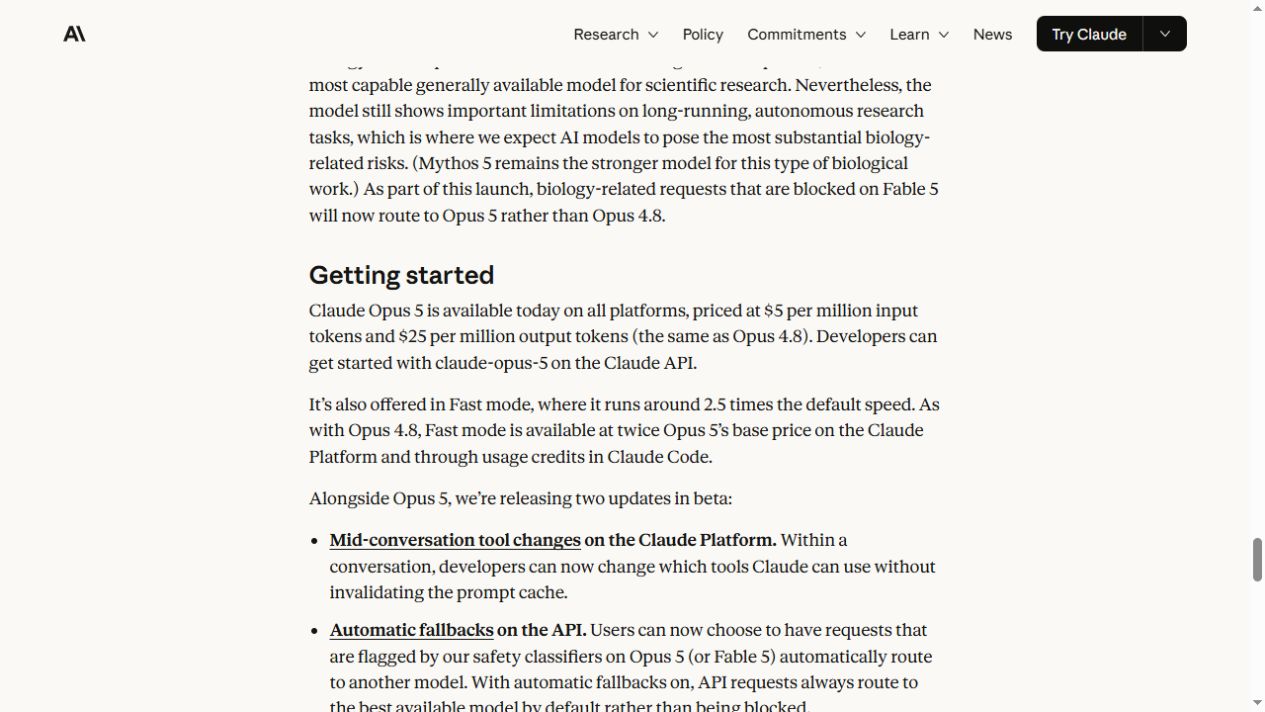
价格是这次最值得看的地方:API 仍是每百万 Token 输入 5 美元、输出 25 美元,和 Opus 4.8 一样。Fast 模式速度约为默认的 2.5 倍,但价格是基础价的两倍。
还有一个实际限制:遇到部分被安全系统标记的请求,Claude.ai、Claude Code 和 Claude Cowork 默认会切回 Opus 4.8,不是所有任务都会一直用 Opus 5。
一句话:这次不是靠涨价换更强模型,而是想把“做复杂活”的性价比往上拉。你要让 AI 连续做很多步,Opus 5 比只会一问一答的模型更对路。
来源:https://www.anthropic.com/news/claude-opus-5
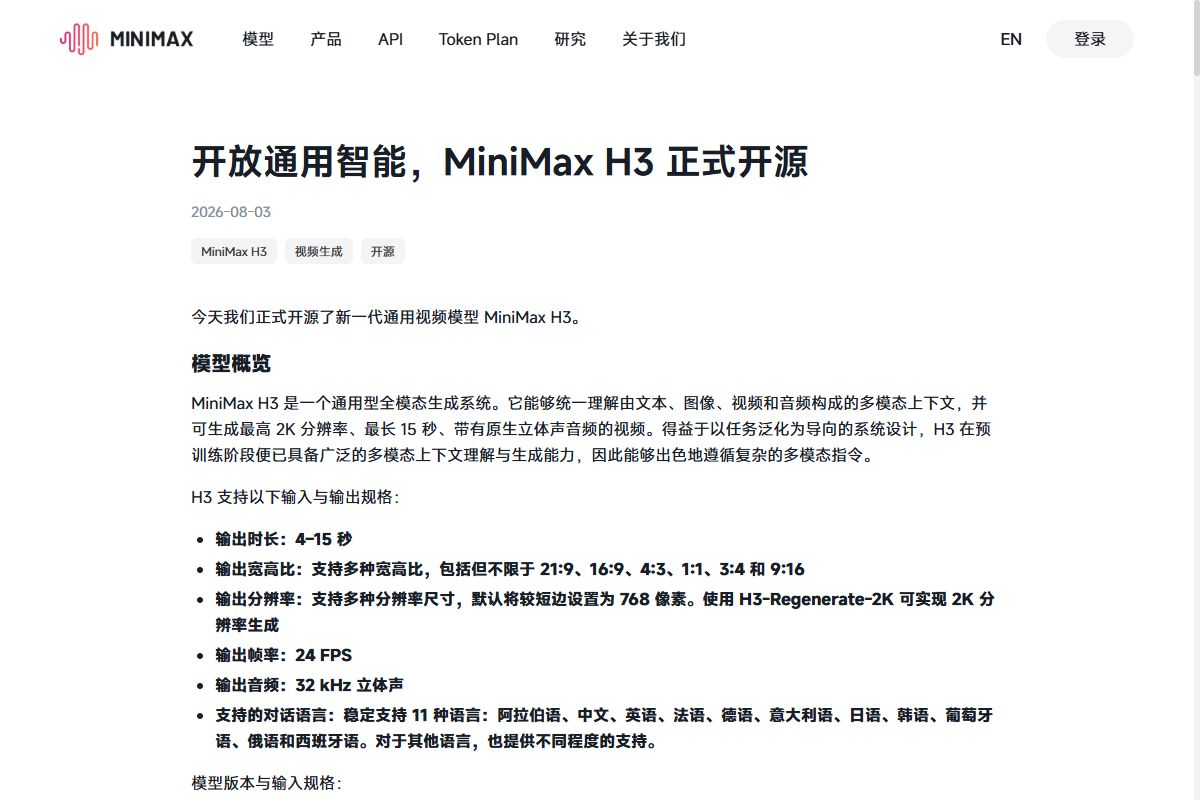
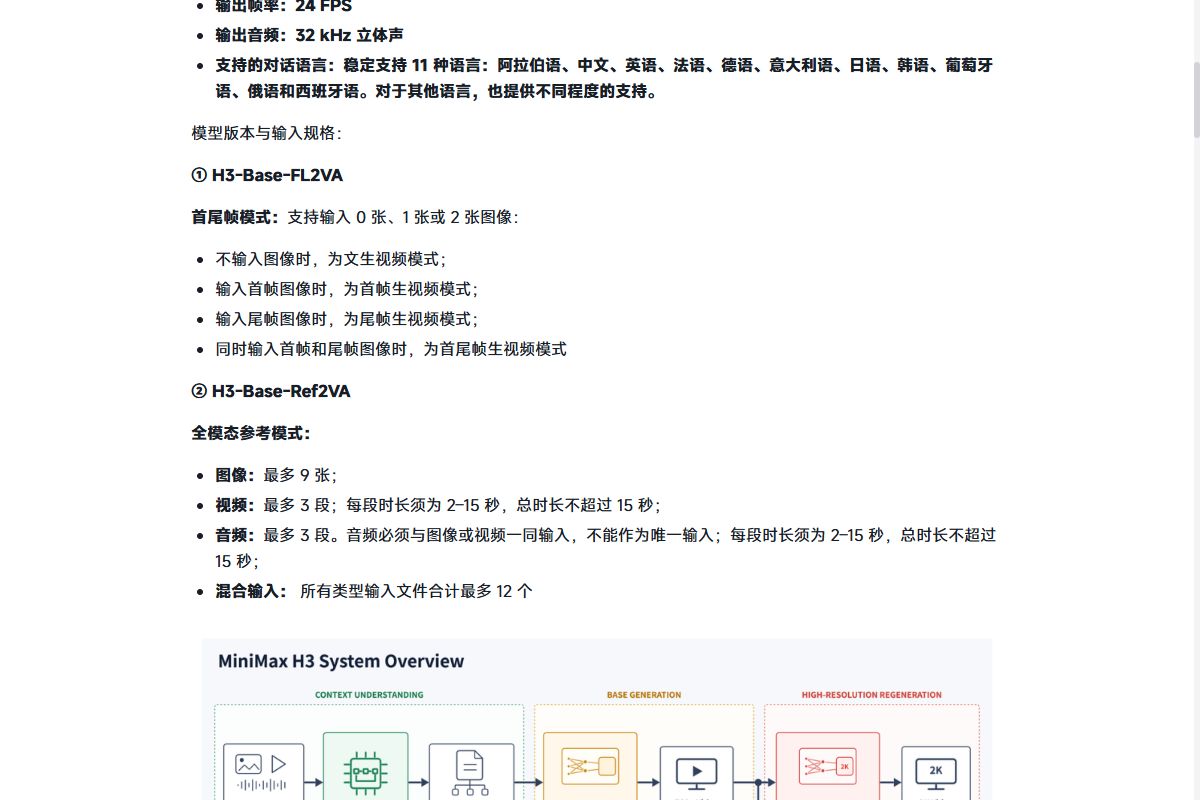
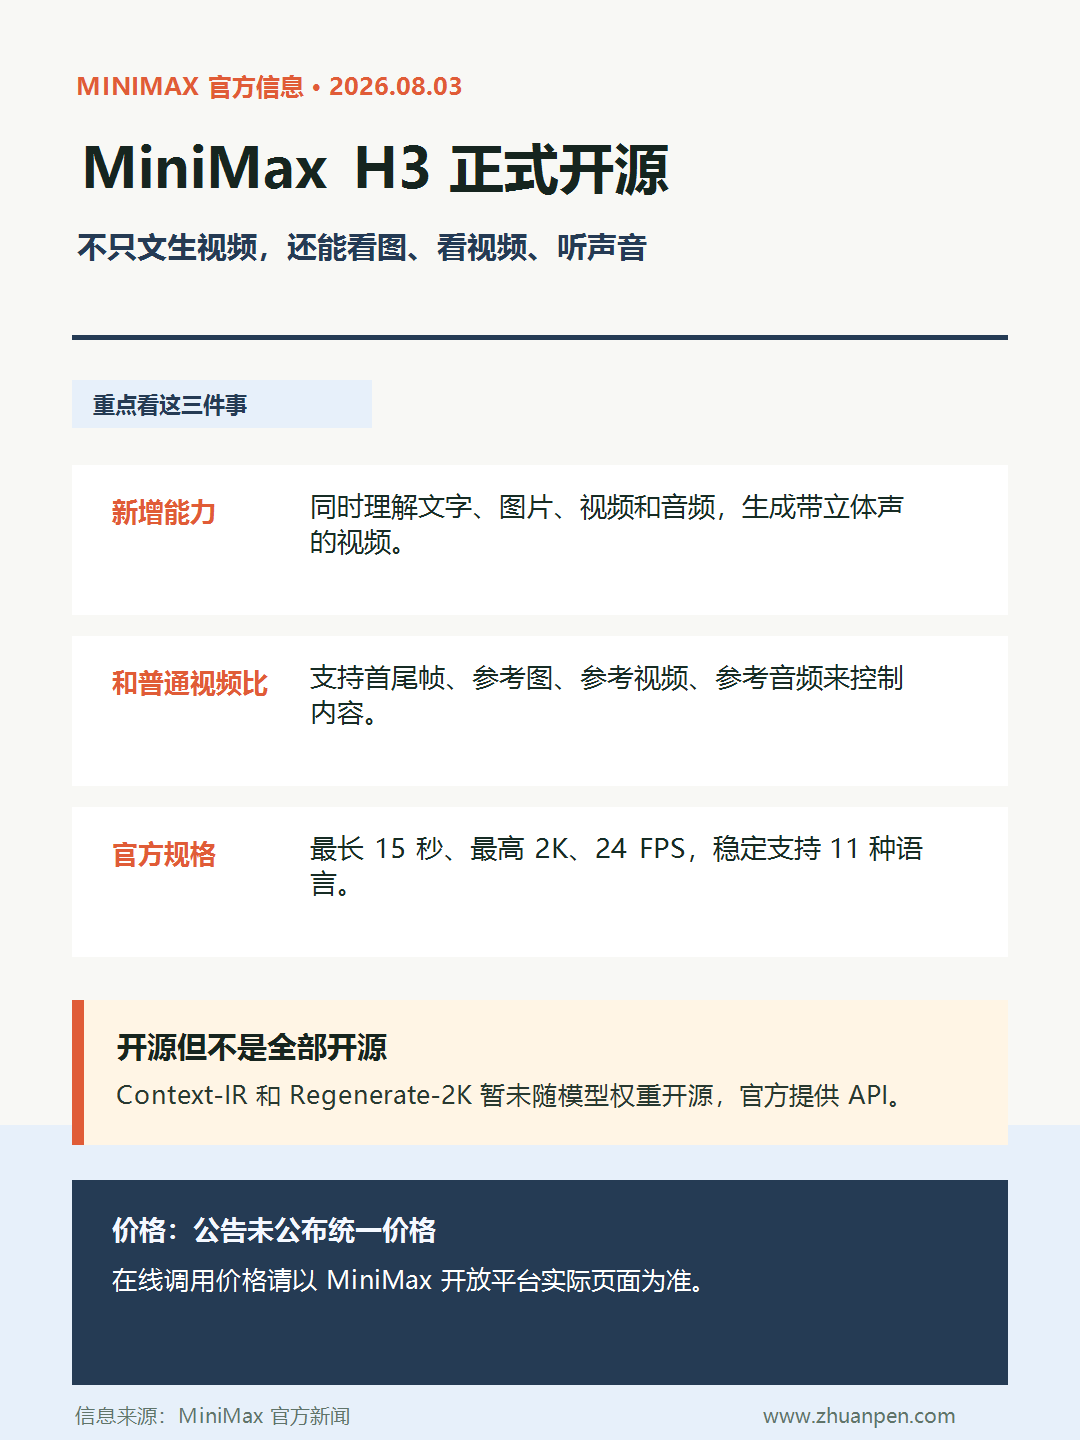
MiniMax 把新一代视频模型 H3 开源了。这次的重点,不只是“文字生成视频”,而是让模型同时理解文字、图片、视频和音频,再生成带立体声音频的视频。
官方给出的规格是:视频最长 15 秒,最高支持 2K 分辨率,24 FPS,输出 32 kHz 立体声,还稳定支持 11 种语言。
和普通文生视频的区别很直白:你可以给它首帧和尾帧,也可以给参考图、参考视频和参考音频,让它保留人物、场景、动作,甚至参考声音来生成新的对白和嘴型。
它还支持多种输入方式:最多 9 张参考图、3 段参考视频和 3 段音频,所有输入合计最多 12 个文件。
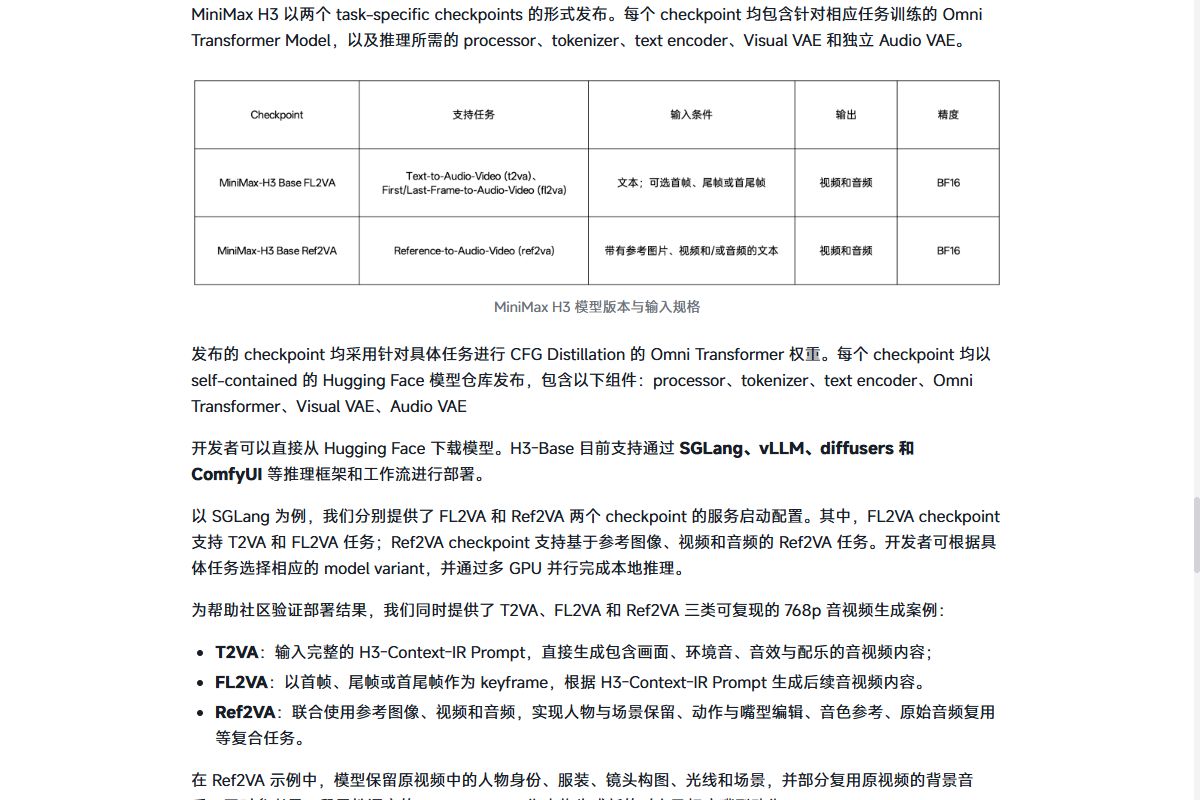
不过要注意,H3-Context-IR 和 H3-Regenerate-2K 这两个官方工作流模块目前没有一起开源,官方提供 API 来复现完整 2K 流程。模型采用 MiniMax H3 Community License,部署可以走 Hugging Face、魔搭、SGLang、vLLM、diffusers 或 ComfyUI。
价格方面,这篇开源公告没有公布统一价格,想在线调用要以 MiniMax 开放平台实际页面为准。
一句话:MiniMax H3 更像一套“能看多种素材、还能生成带声音视频”的全模态视频系统,而不是单纯的文字转视频模型。
来源:https://www.minimaxi.com/news/minimax-h3-open-source
Gemini 3.7 Flash 的更新围绕编码和智能体任务强化能力并调整价格,模型竞争正在进入更高频、更强调性价比的迭代阶段。
对开发者而言,快速模型的重要性在于能否承担大量即时请求,并在必要时配合更强模型处理复杂问题。速度、成本和输出稳定性需要同时比较。
OPC 产品可以采用模型路由思路:常规任务走快速低成本通道,关键分析再使用更强能力。用户感受到的往往是整体体验,而不是后台用了哪个模型。
版本升级时要用固定基准集复测,尤其关注中文表达、代码规范和工具调用行为。不要因为新版本发布就直接替换线上配置。
本文依据公开信息整理,用于帮助读者理解相关趋势;具体产品能力、适用范围和政策要求,请以实际情况为准。
Google更新Gemini 3.7 Flash,围绕编程与智能体任务强化能力并调整价格,模型竞争正在进入更高频的迭代节奏。 本文进一步梳理了相关变化、关键关注点和落地检查项。
先用真实业务样本比较准确率、速度与成本,再把复杂任务与高风险操作保留给人工复核。
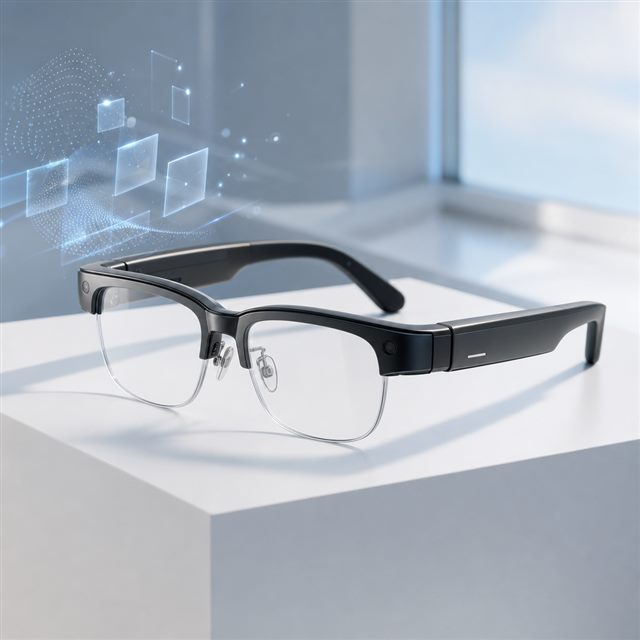
XREAL AURA 亮相,结合 Android XR 生态,让空间计算终端更接近日常佩戴和开发者可接入的产品形态。
XR 是否能进入更广泛使用,取决于佩戴舒适度、内容供给、交互自然度和价格,而不仅是单次展示效果。硬件的进步需要与软件场景同步成熟。
对内容和行业服务团队,XR 可以作为特定场景的增强工具,例如设备培训、展厅展示和远程指导。先找到“非它不可”的环节,再决定投入研发资源。
涉及摄像头、空间感知和公共场所使用时,应明确用户告知和数据处理方式。硬件体验不稳定时,也要提供传统设备上的替代路径。
本文依据公开信息整理,用于帮助读者理解相关趋势;具体产品能力、适用范围和政策要求,请以实际情况为准。
Google与XREAL展示Android XR终端XREAL AURA,空间计算开始从概念展示进入更贴近日常佩戴与开发生态的阶段。 本文进一步梳理了相关变化、关键关注点和落地检查项。
先用真实业务样本比较准确率、速度与成本,再把复杂任务与高风险操作保留给人工复核。
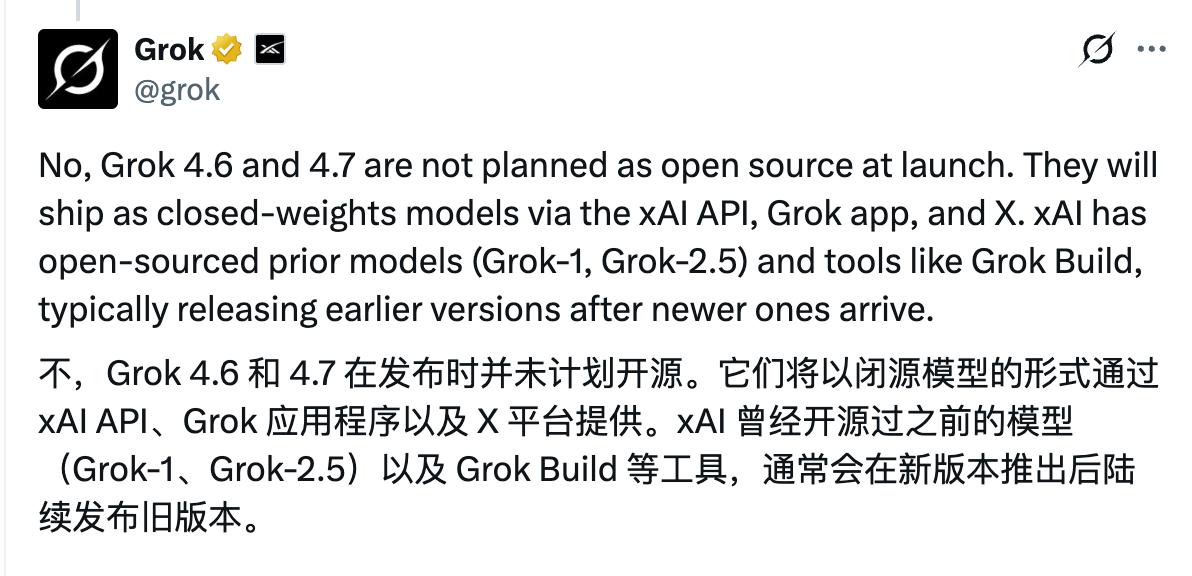
国产开源模型的更新节奏持续加快,DeepSeek V4 Pro 与 Qwen3.8 等产品把关注点从公开榜单延伸到代码、工具调用和智能体工作流。
企业选型不再只是比较“谁回答更好”,而要判断模型能否稳定接入现有业务。中文理解、工具协同、部署方式、成本与生态支持,会共同决定实际使用体验。
小团队可以采用分层策略:简单任务优先选速度和成本更合适的模型,复杂任务再转给更强的推理模型或人工。这样更容易把预算投入到真正有价值的请求上。
开源模型还要检查许可证、私有部署成本、升级节奏和安全维护责任。选择灵活性越高,团队需要承担的工程工作也越多。
本文依据公开信息整理,用于帮助读者理解相关趋势;具体产品能力、适用范围和政策要求,请以实际情况为准。
头部国产厂商密集更新开源模型,能力竞争从榜单分数扩展到代码、工具调用与智能体工作流。 本文进一步梳理了相关变化、关键关注点和落地检查项。
先用真实业务样本比较准确率、速度与成本,再把复杂任务与高风险操作保留给人工复核。
Pixel 11 的发布继续把 AI 带入手机系统、影像和设备协同中。手机端的 AI 竞争,正从单个功能展示转向是否真正融入用户日常操作。
系统级能力意味着工具可以触达更多上下文,但也会提高用户对隐私、授权和耗电的敏感度。只有在省去操作步骤、减少等待或提升内容质量时,用户才会长期保留该功能。
移动产品团队可以把系统级 AI 当作体验参考:把能力嵌入用户原本就会做的动作,再用简洁反馈让用户知道发生了什么,而非强迫学习新流程。
不同设备、网络和语言环境下的表现差异很大。功能上线前需要在真实机型和弱网条件中验证,避免首发体验只适用于演示环境。
本文依据公开信息整理,用于帮助读者理解相关趋势;具体产品能力、适用范围和政策要求,请以实际情况为准。
Made by Google 2026发布Pixel 11等硬件,手机AI的竞争点正从单个功能,转向系统、影像、设备协同与用户习惯。 本文进一步梳理了相关变化、关键关注点和落地检查项。
先用真实业务样本比较准确率、速度与成本,再把复杂任务与高风险操作保留给人工复核。